
我們每天都在「看」圖片,看到一張照片時,我們幾乎不需要思考,就可以知道照片裡有沒有人、這是什麼東西、物體大概位於哪裡。
例如看到一張狗的照片,我們很自然就會說:「這是一隻狗。」
但對電腦來說,事情並沒有這麼簡單。電腦真的「看得到」這隻狗嗎?
其實,電腦一開始根本不知道什麼是狗、什麼是人。
它真正接收到的,只是一堆數字。
這也是這 30 天我想介紹的主題的:我們究竟要怎麼讓電腦從一堆數字中,逐漸學會辨認圖片?
人類透過眼睛接收影像,再由大腦判斷看到的是什麼,而 Computer Vision 想做的事情有點類似,只不過我們要把這個過程交給電腦。
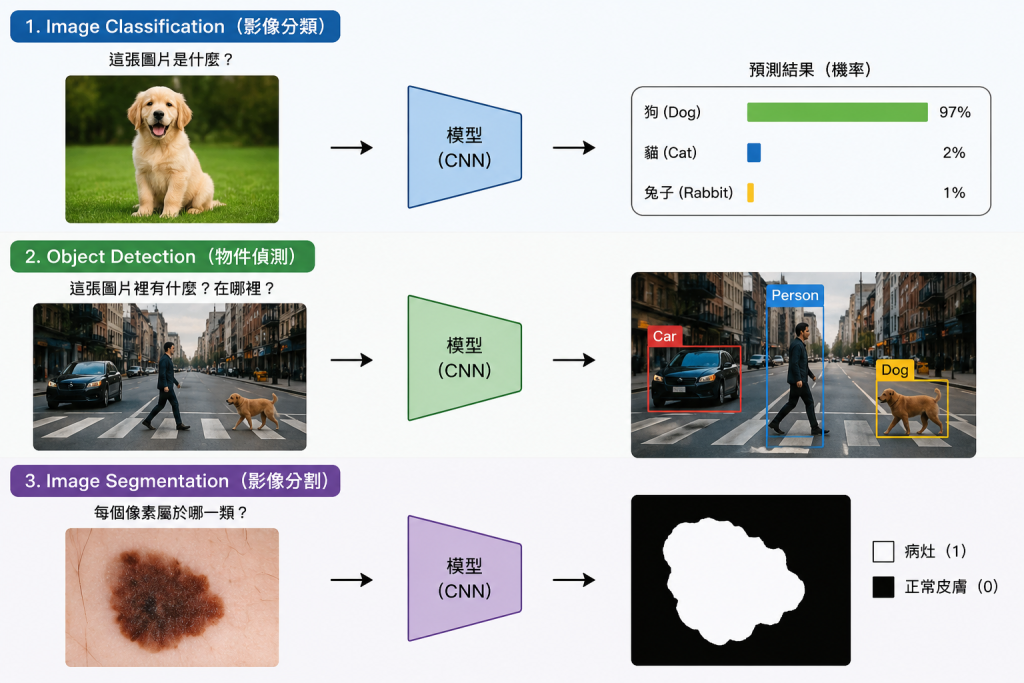
例如給電腦一張狗的圖片,我們希望它最後可以告訴我們:
這張圖片有 97% 的機率是一隻狗,有 2% 的機率是一隻貓,另外有 1% 的機率屬於其他類別。
也就是說,模型不只會給出一個答案,還會同時提供它對每個類別的預測機率。不過,Computer Vision 並不只有「這張圖片是什麼?」這一種問題。
根據我們希望電腦回答的問題不同,可以分成許多不同的任務。
今天先認識其中三種很常見的任務:
我們想要它回答的問題最簡單:「這張圖片是什麼?」
例如我們準備三種類別:貓、狗、兔子,接著丟一張狗的照片給模型,模型可能告訴我們他是狗的機率有95%、是貓的機率有3%、是兔子的機率有2%,最後我們就可以把這張圖片分類成狗
不只告訴我「是什麼」,還要告訴我「在哪裡」
假設現在有一張街道照片,裡面同時有一個人、一台車、一隻狗。如果使用 Image Classification,它比較像是在回答:「這張圖片裡可能有狗。」但是如果我還想知道狗到底在哪裡?這時候就需要 Object Detection(物件偵測)。
模型會用一個框框把物體圈起來,這個框通常叫做 Bounding Box。
Object Detection 已經可以知道物體在哪裡了,為什麼還需要其他方法?
因為 Bounding Box 是一個「方框」,假設今天我們想找的是一塊形狀不規則的皮膚病灶,如果只用 Bounding Box,只能大概把這一整塊框起來。但有時候我們想知道病灶真正的邊界到底在哪裡?這時候就會用到 Image Segmentation(影像分割)。
它會更仔細地去判斷哪些 Pixel 屬於病灶?哪些 Pixel 屬於正常皮膚?因此在醫學影像中,Segmentation 也有很多應用,例如找出腫瘤範圍、器官範圍或病灶邊界。
接下來 30 天,使用 HAM10000 皮膚病灶影像資料,一步一步了解圖片是怎麼被電腦讀取、模型又是怎麼從圖片中學習特徵。
下一篇,就先從我們之後會一直使用的工具 Google Colab 開始。


 iThome鐵人賽
 看影片追技術